 Lavik
将 300 节点 Redis 集群迁移到仅 3 个 Lavik 节点
为何不断为内存购买服务器?Lavik 将 NVMe SSD 容量与超过 DRAM 上 Redis 的吞吐结合,深入解析从 300 节点整合到三节点的架构、实测与成本。
内存已经用满,CPU 却还有余量。每增加一批需要保留的数据,就得再加一个 Redis 分片、一个副本,以及两台需要维护的服务器。对于容量受限的应用,这是一条昂贵的扩容路径。Lavik 用 NVMe SSD 承载应用数据,并在公开测试中实现了每秒 114 万次 GET,吞吐超过使用 DRAM 的 Redis。这让基础设施有了新的选择:把因内存容量而膨胀的集群整合到少量高存储密度服务器上,同时为持续增长的智能体状态留出空间。[13][1]
1. 智能体需要更多状态,也需要快速访问
面向人的应用通常为每个用户保存资料、会话和一组特征。智能体应用则可能为同一用户的研究助手、编程助手和多个后台工作进程分别维护这些信息。每个智能体都在积累执行状态、观察结果和工作上下文。即使某个智能体只是偶尔运行,它恢复执行时仍然需要立即读取状态。容量取决于智能体数量、状态大小和保留时间,而请求量不一定按同样的速度增长。[1]
十亿个智能体,每个仅保留 1 KB 特征,就会产生约 1 TB 数据。每个保留 10 KB,总量便达到 10 TB;增加到 100 KB,则达到 100 TB,还没有计入键、索引和副本。应用仍然需要通过熟悉的 Redis 客户端和数据结构完成低延迟读写。把所有保留的数据都放在昂贵的 DRAM 中,会让这一需求越来越难以负担。Lavik 的设计目标,就是让这类对延迟敏感的应用也能利用 NVMe SSD 的容量优势。[1][6]
| 每个 Agent 大小 | 唯一值载荷 | 三份副本,仅值 |
|---|---|---|
| 1 KB | 1 TB | 3 TB |
| 10 KB | 10 TB | 30 TB |
| 100 KB | 100 TB | 300 TB |
2. 不再为了增加内存而不断增加服务器
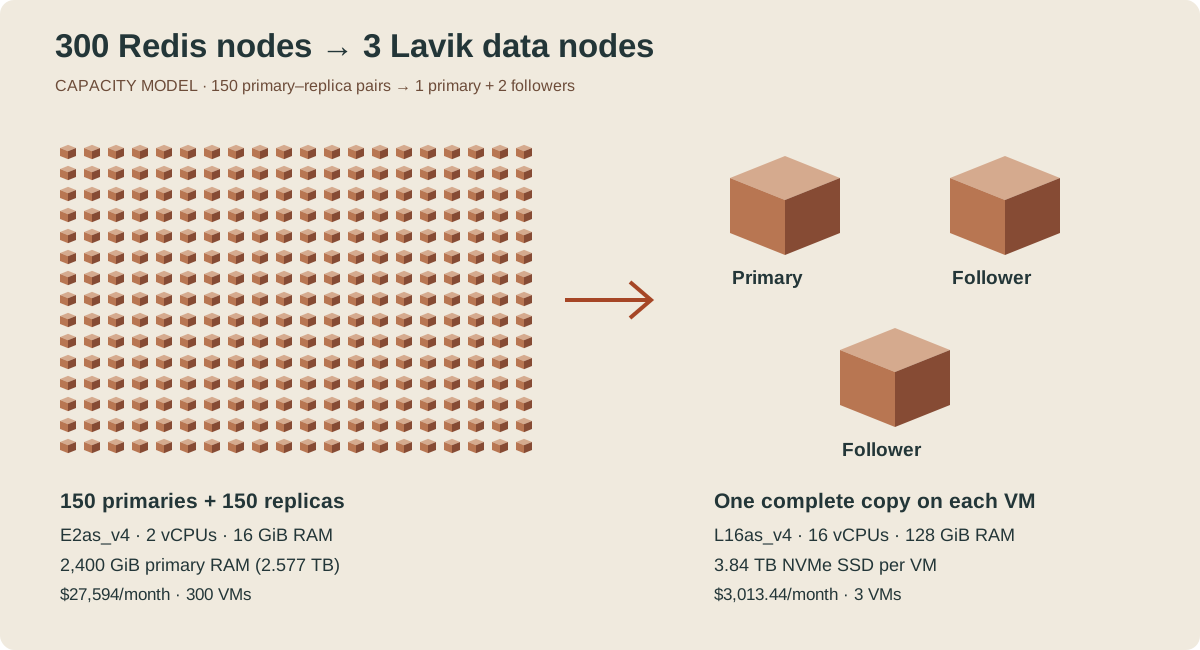
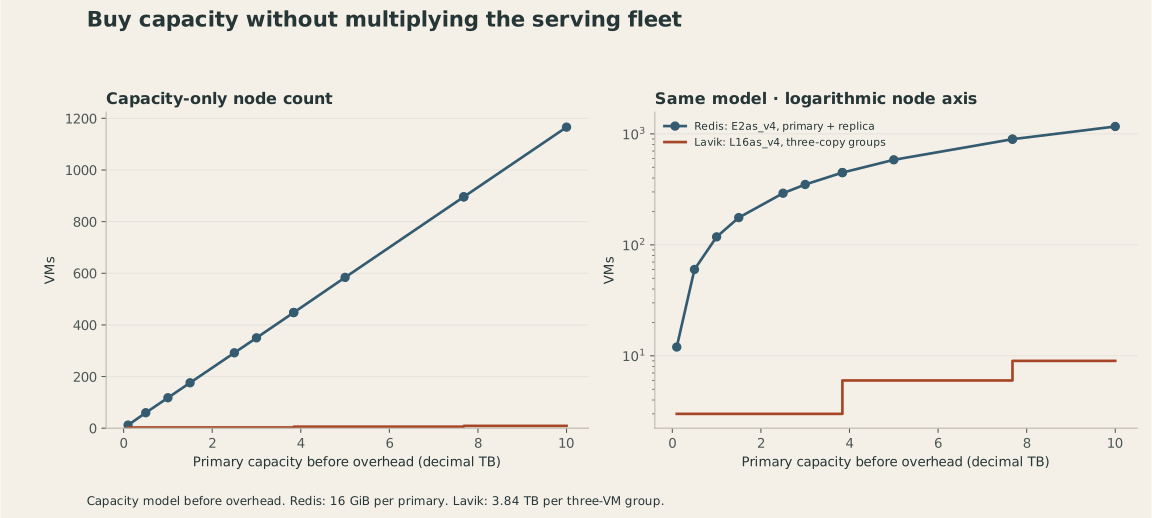
考虑 300 台 Standard_E2as_v4 Azure 虚拟机,每台两个 vCPU、16 GiB RAM,组成 150 个主节点和 150 个副本节点。整个集群购买了 600 个 vCPU、4,800 GiB RAM,其中主节点合计提供 2,400 GiB。当内存先耗尽时,扩容购买的 CPU、网络和操作系统资源,很大程度上只是获取更多 RAM 的附带成本。应用可能只是需要保留更多资料或延长会话寿命,并不需要同比增加计算能力。Redis 成本优化的关键就在这里:按请求量配置计算资源,按数据量选择存储密度。[1][28]
两种部署采用相同的 Azure 区域和购买方式:美国东部 2(East US 2)、Linux 按量付费,价格以美元计。Microsoft 公布的 Standard_E2as_v4 费率为每小时 0.126 美元,Standard_L16as_v4 为每小时 1.376 美元。按每月 730 小时计算,300 台 Redis 虚拟机为每月 27,594 美元,三台 Lavik 虚拟机为每月 3,013.44 美元。每台 Lavik 虚拟机包含 16 个 vCPU、128 GiB RAM 和 3.84 TB 本地 NVMe SSD。这让整合方案的成本比较直接建立在同一云厂商的公开虚拟机价格上。[27][29][1]
增加闪存并不会自动解决延迟问题。Redis 将 Flex 的闪存访问描述为毫秒级,并明确不推荐将它用于访问范围广、工作集大或数据频繁在 RAM 与闪存间移动的场景。对于延迟预算低于一毫秒的应用,毫秒级闪存路径就过慢了。智能体不断访问不同的资料和上下文时,这一区别尤为重要:当访问范围超出 RAM,存储引擎仍然需要高效处理大数据集。[25][26]
月度虚拟机费用减少 24,580.56 美元,降幅为 89.1%,年化节省 294,966.72 美元。三台 Lavik 虚拟机合计提供 48 个 vCPU、384 GiB RAM,由 NVMe SSD 承载数据容量。Redis 的 300 台虚拟机则提供 600 个 vCPU,容量受限的负载可能并不需要其中相当一部分计算资源。高存储密度的经济价值就在于:按请求处理需求购买计算能力,用 SSD 容量保留数据。下表两侧均为自建虚拟机成本,操作系统磁盘、备份和流量费用另计。[1][27]
| 部署 | 美元 / 虚拟机·小时 | 月费(美元) | 年费(美元) | 平均百万 QPS 时每百万次操作美元成本 |
|---|---|---|---|---|
| Redis · 300 × Standard_E2as_v4 | $0.126 | $27,594.00 | $331,128.00 | $0.01050 |
| Lavik · 3 × Standard_L16as_v4 | $1.376 | $3,013.44 | $36,161.28 | $0.00115 |
3. 围绕 NVMe SSD 构建容量
Lavik 容量方案采用三台 Standard_L16as_v4 虚拟机。每台包含 16 个 vCPU、128 GiB RAM 和四块 960 GB 本地 NVMe,每台合计 3.84 TB。每台运行一个 Data 进程和一个 Meta 投票节点,组成一个主节点、两个完整跟随副本。每台虚拟机保存完整数据集。部署结构因此很直观:三个数据放置位置、三个控制平面投票节点,以及每个服务节点上的 NVMe 容量。[1][29][6][11][7]
每台虚拟机保存完整副本时,单份数据的容量基数为 3.84 TB。成本表使用这一分母,三台虚拟机的单位容量成本为每 TB 每月 784.75 美元。Redis 的 150 个主节点合计提供 2,400 GiB,约合十进制 2.577 TB,对应每 TB 每月 10,707.88 美元。这些指标按容量归一化虚拟机费用,尚未扣除数据库开销和运行所需的空闲空间。复制将同一个逻辑数据集放在三台 Lavik 虚拟机上;单台故障后,仍有两份数据和 Meta 多数派可用于恢复与提升。[1][27][28][29][11][7]
| 部署 | 单份数据容量分母 | 美元 / TB·月 |
|---|---|---|
| Redis · 300 × E2as_v4 | 2,400 GiB RAM (≈ 2.577 TB) | $10,707.88 |
| Lavik · 3 × L16as_v4 | 3.84 TB NVMe SSD | $784.75 |
Lavik 将 DRAM 用在请求路径上最需要它的地方:键索引、元数据和活跃缓冲区;值数据则使用 NVMe SSD 容量。这把值字节数的增长与索引内存的增长分开,特别适合越来越大的智能体资料和上下文。内存配置应依据键数量、键长度,以及缓冲区、大页和复制积压空间。公开的大数据集实验在一台 125.8 GiB 内存的主机上容纳了十亿键布局,对应的值数据约为一 TB。[9][13]
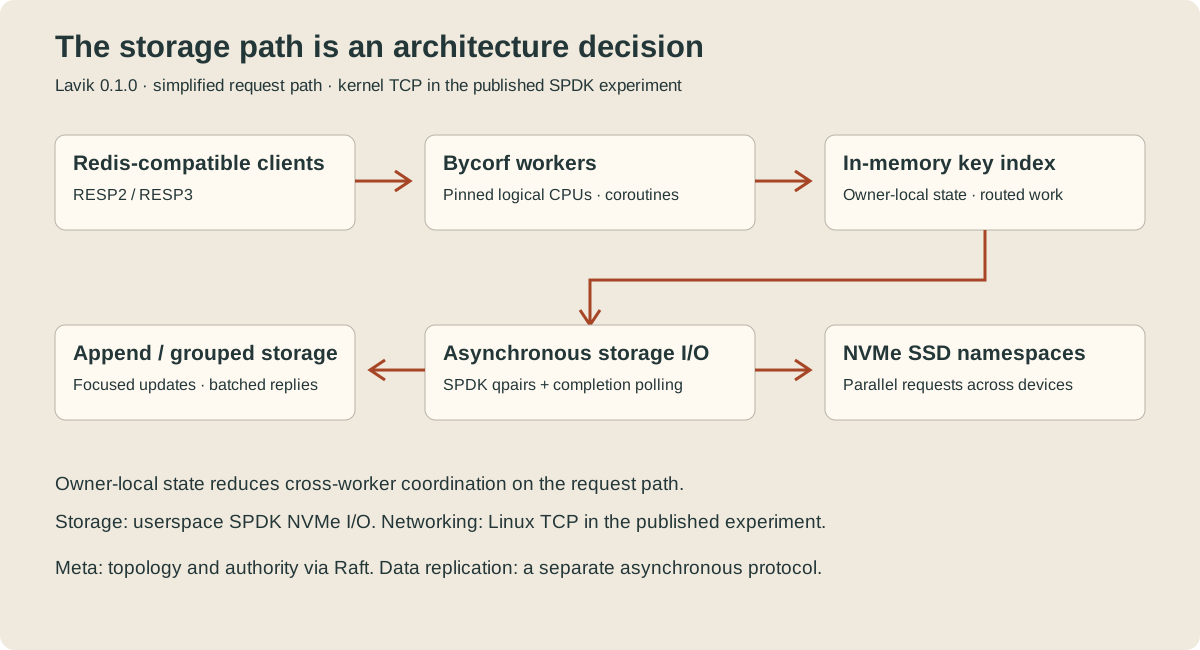
SPDK 让存储 I/O 路径更直接。Lavik 通过用户态 NVMe 队列对提交操作,并轮询完成事件,绕过内核块 I/O 提交路径,减少系统调用和唤醒开销。异步请求使存储操作保持在途,同时让工作线程推进其他命令。轮询用 CPU 时间换取及时的完成处理;队列深度、完成批次和 CPU 绑定决定这些计算资源的使用效率。现代 NVMe 设备提供并行队列和内部并发能力,存储引擎则负责持续提供足够的独立工作。[4][5][13]
Lavik 的 Bycorf 工作线程使用协程、本地归属的可变状态和显式跨线程分发。一条命令等待存储时,其他可运行任务仍可继续。明确的状态归属让常见操作靠近其修改的数据,减少核心之间的协调。每秒执行百万次操作时,即使很小的调度、同步或分配开销,也会累积成可观的 CPU 消耗。将执行模型与存储一起设计,才能利用 SSD 并行能力,同时避免每次 I/O 都阻塞整个请求处理线程。[6][8][9]
优化贯穿整条请求路径。满足条件的磁盘 GET 可以在连接工作线程上使用获准的索引快照,通过快速路径避免分发到归属线程。解析器每批最多处理 128 条命令,小型流水线回复可合并为 64 KiB 写入。每工作线程的追加流避免了为每个逻辑槽分配暂存缓冲区。这些设计共同减少协调、系统调用和缓冲开销。应用继续使用熟悉的 Redis 兼容接口,底层实现则围绕高效并发存储访问组织。[8][9]
大对象同样得到针对性优化。Lavik 0.1.0 为 String、Hash、Set、List、Sorted Set 和 Stream 提供分组存储。大字符串使用 8 KiB 分段,集合使用可独立寻址的分组。局部操作可以只处理相关部分,避免每次小改动都重写整个大对象。对于特征持续更新、同时保留大量状态的智能体资料,这种布局能把一次更新限制在更小的范围内。NVMe 性能既取决于 I/O 调度,也取决于每次操作实际触碰多少数据。[10]
4. 数据放在 SSD,吞吐超过 DRAM 上的 Redis
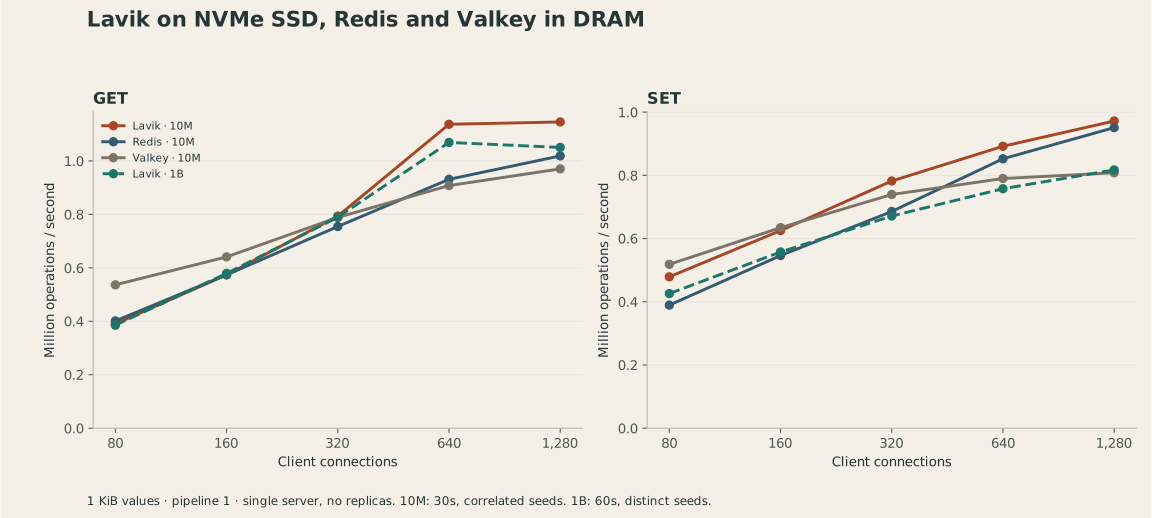
直接对比使用同一台 16 vCPU Azure 服务器,运行 Lavik 0.1.0 SPDK、Redis 8.10.2 和 Valkey 9.1.2。独立压测机通过私有网络发起均匀随机 GET 和 SET,值大小为 1 KiB,流水线深度为一。Redis 和 Valkey 从 DRAM 提供值数据,Lavik 使用 NVMe 存储路径。下表同时展示吞吐和客户端观测延迟,方便按应用的延迟预算选择运行点。[13]
在 1,280 个连接下,Lavik 实现 1,145,772 GET QPS 和 971,950 SET QPS。GET 吞吐比 Redis 高 12.5%,比 Valkey 高 18.1%;SET 吞吐比 Redis 高 2.2%。在这一运行点,Lavik 的 GET P99 为 3.999 ms,Redis 为 4.415 ms。这正是整合基础设施值得考虑的原因:采用 NVMe 容量的系统可以获得高于内存服务器的吞吐,应用无需仅为降低存储成本而接受性能折损。[16][13]
| 系统 / 操作 | QPS | 平均 | P50 | P95 | P99 | P99.9 |
|---|---|---|---|---|---|---|
| Lavik 0.1.0 SPDK GET | 1,145,772 | 1.117 | 1.031 | 1.511 | 3.999 | 7.135 |
| Lavik 0.1.0 SPDK SET | 971,950 | 1.317 | 1.119 | 2.783 | 4.479 | 7.199 |
| Redis 8.10.2 GET | 1,018,735 | 1.256 | 1.087 | 2.479 | 4.415 | 7.103 |
| Redis 8.10.2 SET | 951,053 | 1.346 | 1.135 | 2.943 | 4.511 | 7.231 |
| Valkey 9.1.2 GET | 970,288 | 1.319 | 1.119 | 2.511 | 4.415 | 7.455 |
| Valkey 9.1.2 SET | 808,103 | 1.583 | 1.455 | 2.559 | 4.047 | 7.199 |
延迟还取决于服务器承受的负载。在十亿键数据集、80 个连接的运行点,Lavik 达到 385,514 GET QPS,P99.9 为 0.439 ms;连接数增至 640 时,GET 吞吐超过一百万。基础设施团队可以沿曲线选择需要的吞吐与尾延迟组合。为突发流量保留余量,比单纯根据曲线上的最高吞吐点配置生产系统更有价值。[13]
十亿键包含 1.024 TB 原始值数据,约为服务器 RAM 的 7.6 倍,峰值 GET 吞吐达到 1,069,126 QPS。Lavik 的性能因此不局限于能装进内存的数据集。小规格实例也呈现出相同的容量优势:在两个 vCPU、标称 16 GiB RAM 下,将一百万条 1 KiB 数据增加到一亿条,GET 峰值仅从 215,521 变为 215,463 QPS,SET 保持小数据集峰值的 95.2%。无论是紧凑服务还是大型智能体平台,这意味着容量增长不必要求服务节点数量同步增加。[13][14]
智能体状态也需要频繁更新。在独立的 io_uring YCSB 实验中,Lavik 在 50/50 读更新混合负载下达到 529,501 QPS,在 95/5 混合负载下达到 577,373 QPS。这里执行的是结构化记录操作:对一亿条记录进行 HGETALL 读取和 LAVIK.HREPLACE 更新,每条包含十个 128 字节字段。这展示了 Lavik 在纯 GET 之外的应用价值,包括随着任务推进不断变化的智能体特征记录。[15]
| Lavik 负载 | 总 QPS | READ P99.9 ms | UPDATE P99.9 ms |
|---|---|---|---|
| 50% HGETALL / 50% HREPLACE | 529,501 | 5.083 | 2.831 |
| 95% HGETALL / 5% HREPLACE | 577,373 | 1.818 | 1.578 |
如果持续运行,每秒一百万次操作相当于每天 864 亿次操作。这样的实测服务能力与 NVMe 存储密度结合,为重新评估容量受限的集群提供了充分理由。先确定实际流量范围,包括命令组合、峰值、突发和延迟目标,再据此配置计算资源,让 NVMe SSD 承载应用需要记住的数据。[1][13]
5. 更少节点,更少集群协调工作
因内存而扩容,也会扩大工程师需要管理的拓扑。Redis Cluster 分配 16,384 个哈希槽,使用全互联集群总线。规范规定,每个节点建立 N−1 条出站连接,并接受 N−1 条入站连接。全群合计有 N(N−1) 条发起的总线连接:300 节点时为 89,700 条,600 节点时为 359,400 条,1,000 节点时为 999,000 条。这些连接用于集群通信,与应用连接分开。通过不断增加节点来容纳智能体状态,也会不断扩大协调网络。[2]
集群通过 gossip、心跳探测和故障报告维护成员状态。局部故障怀疑需要结合其他节点的报告判断;故障转移需要授权和配置纪元。在网络分区或滚动重启期间,工程师必须弄清哪些主节点、副本及网络路径仍然可达。即使请求处理能力足够,更多成员也会带来更多需要诊断的位置和关系。集群成本既包括虚拟机账单,也包括这些运维工作。[2]
重新分片涉及数据移动、归属变更和客户端重定向。日常维护还包括补丁、重启、监控及副本放置。高存储密度的 Lavik 部署减少了为容量而增加的 Data 进程,并为每个进程留出增长空间。Meta 服务管理拓扑和权限,原生复制维护跟随副本。对于容量受限的应用,缩减集群可以同时减少两项成本:为了内存购买的服务器,以及管理这些服务器所需的工作。[3][6][11][7]
6. 整合基础设施,保持服务目标
最适合整合的场景很明确:内存压力不断推动扩容,而 CPU 利用率和流量仍低于集群的处理能力。选择代表性负载,按命令、键数量、值分布和最繁忙时段配置 Lavik。严格的尾延迟目标或 CPU 密集型命令组合可能需要更多服务资源。架构优势始终在于:保留多少数据,不再仅由 DRAM 容量决定需要多少节点。[1][6]
从部署开始就规划可用性。将虚拟机放在合适的故障域,并将 Meta 状态保存在持久磁盘上。Azure 本地 NVMe 属于临时存储,因此应将跨虚拟机复制与外部备份结合使用。在复制、过期和空间回收运行时测量服务延迟,再按目标数据规模演练主节点故障和跟随副本重建。Lavik 的 Meta 通过 Raft 管理拓扑和权限,Data 复制采用异步方式。相应设定应用的恢复点和恢复时间目标,再通过故障演练验证。[29][11][7][1]
使用 RedisShake 从现有 Redis 部署迁移。先梳理命令与键形态,创建受管 Lavik 目标,复制基线数据并追赶增量。在切换前核对键数量、值和过期时间;暂停源端写入完成最终追平,再切换客户端,并为目标端已接收的新写入准备回退流程。源集群的分片数量无需决定目标的物理布局。文末链接的迁移指南提供与版本绑定的配置和操作步骤,可将整合方案落实为可执行的迁移。[12]
7. 给智能体状态留出增长空间
当保留数据从 1 TB 增长到 10 TB 甚至更大,每新增一 TB 的成本就会成为产品约束。Lavik 提供了另一种基础:Redis 兼容的 NVMe 键值存储、实测超过 DRAM 上 Redis 的吞吐、高效的大对象布局,以及 Apache 2.0 开源许可。从应用实际使用的命令开始,加载代表性数据集,测量用户真正需要的延迟目标。从 300 个 Redis 节点到三个 Lavik 节点,核心机会是按真实计算需求建设基础设施,并让数据拥有持续增长的空间。[6][10][13][1]
测试与容量说明
测试环境:Azure Standard_L16aos_v4,日本西部(Japan West),可用区 2,AMD EPYC 9V74,16 个逻辑 CPU(八个物理核心,开启 SMT),125.8 GiB RAM,六块 1.92 TB NVMe。F32als_v6 客户端使用 16 个线程,经私有加速 mlx5 网络和 Linux TCP 压测。一千万键测试窗口为 30 秒,客户端种子相关;十亿键窗口为 60 秒,使用不同种子。Lavik 配置 8 GiB 大页、开启 defrag,每轮最多处理 16 个完成事件。所选 Redis GET/SET I/O 线程数均为 16,Valkey GET 为 16、SET 为八。测试均为单服务器,无 Data 副本;Redis 和 Valkey 关闭 AOF 与定时快照。[13]
测量方法:每个曲线点对应一个测量窗口。延迟来自整个窗口的 memtier 输出,P95 从内嵌 HDR 直方图解码。混合负载实验使用 io_uring、12 个 Lavik 工作线程和四个系统/IRQ CPU、256 个客户端工作线程,每窗口 300 秒,无副本。报告覆盖图表中的负载;生产选型还应测量应用自身的值大小、命令组合和启用复制后的尾延迟。[16][13][15]
容量与成本依据:Azure 对比使用 300 台 E2as_v4 和三台 L16as_v4,按美国东部 2 区域的 Linux 按量费率、每月 730 小时计算,年费为 12 个月费用。容量归一化仅计算一份逻辑数据:Redis 主节点 RAM 合计 2,400 GiB,Lavik NVMe SSD 为 3.84 TB,均未扣除开销。吞吐数据使用前文所列的独立 L16aos_v4 压测配置。每百万操作成本按平均持续 100 万 QPS 计算。虚拟机价格不含托管磁盘、外部备份、流量、人员和税费。[1][27][28][29][13]